Tema 2: Procesos vs. hilos
Procesos
Concepto y ciclo de vida
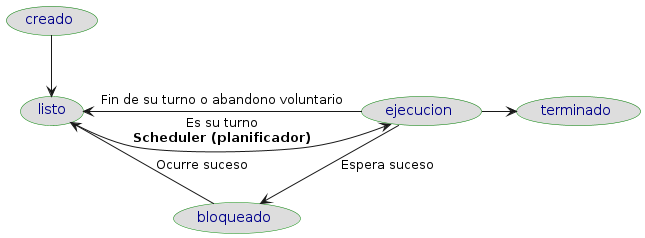
- El ciclo de vida de un proceso es el siguiente:
-
El encargado de darle la oportunidad de usar la CPU es el Planificador de procesos o Scheduler → forma parte del núcleo del SO. En este otro enlace tienes más información sobre el planificador del núcleo Linux.
-
Y en este vídeo puedes ver que puede pasar si un atacante se puede hacer con el control del planificador.
-
Una forma bastante justa y extendida es hacerlo mediante asignación de rodajas de tiempo:
- Cuando un proceso cumple su tiempo de permanencia en el procesador, éste es desalojado y pasado a Listo. Esperará una nueva oportunidad para pasar a ejecución. También puede abandonar voluntariamente la CPU
-
El acto de cambiar un proceso de estado se llama Cambio de contexto. Se trata de una operación costosa
-
En un SO tradicional, la memoria se divide en:
- Espacio de usuario: en él se encuentra la mayor parte de la información relativa a los procesos de usuario
- Espacio de núcleo: en él reside el código y las estructuras propias del sistema operativo.
-
La información relativa a un proceso suele estar dividida entre los dos espacios.
-
La parte del espacio del núcleo contiene lo que se conoce como bloque de control del proceso
Procesos en Unix
-
En Unix todos los procesos, excepto el primero (el número
0), se crean con una llamada afork(). Puedes ver un contraargumento al uso deforken este artículo. Puedes ver toda la información relativa aforkcon la orden:man 2 forko también aquí. -
Para optimizar la creación del nuevo proceso se emplean técnicas como Copy On Write (COW).
-
El proceso que invoca a
forkes el proceso padre. -
El proceso creado es el proceso hijo.
-
El proceso
0se crea en el arranque. Hace una llamada aforkpara crear el proceso1,init, y a continuación se convierte en el proceso "intercambiador de procesos". -
Podemos observar la tabla de procesos activos con instrucciones como
top,htop,ps, etc…
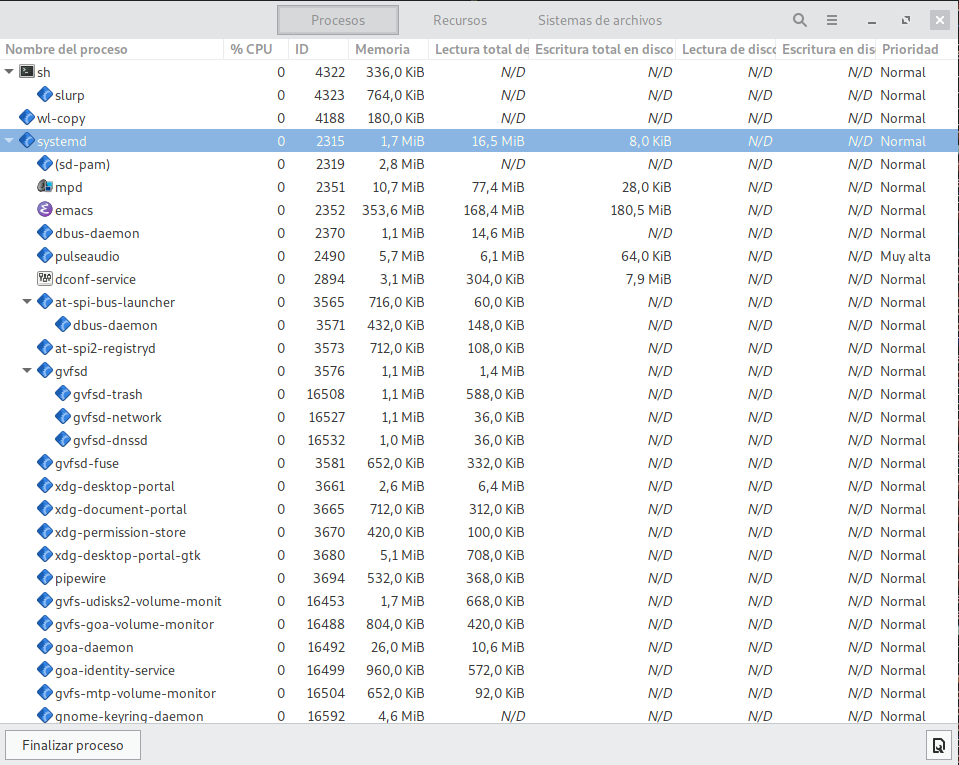
Figure 2: Ciclo de vida.
int pid;

if ( (pid = fork()) == -1 )
    perror ("Error en la llamada a fork");
else if (pid == 0)
    // código que ejecutará el proceso hijo
else
    // código que ejecutará el proceso padre
-
La llamada a fork duplica todo el contexto del proceso. Es interesante que conozcas el uso idiomático de
fork-exec. Para todo ello, echa un vistazo a este vídeo. -
Todas las variables, incluidas las globales y las estáticas, son inaccesibles para el otro proceso: compartir información es complicado y requiere mecanismos de comunicación entre procesos (IPC).
Ejemplo práctico de procesos en C (
fork): (Código disponible enprocesos.c)
#include <sys/types.h>
#include <unistd.h>
#include <sys/wait.h>
#include <stdlib.h>
#include <stdio.h>

#define NUM_PROCESOS 5
int I = 0; // Variable global

void codigo_del_proceso (int id) {
    int i;
    for (i = 0; i < 50; i++)
        printf("Proceso %d: i = %d, I = %d\n", id, i, I++);
    exit(id);
}

int main() {
    int p;
    int id [NUM_PROCESOS] = {1,2,3,4,5};
    int pid, salida;

    for (p = 0; p < NUM_PROCESOS; p++) {
        pid = fork ();
        if (pid == -1) {
            perror ("Error al crear proceso");
            exit (-1);
        }
        else if (pid == 0) // Código del hijo
            codigo_del_proceso (id[p]);
    }
    // Código del padre: espera a que terminen los 5 hijos
    for (p = 0; p < NUM_PROCESOS; p++) {
        pid = wait (&salida);
        printf("Proceso %d con id = %d terminado\n", pid, WEXITSTATUS(salida));
    }
}
Salida:
$ gcc -o procesos procesos.c && ./procesos
Proceso 1: i = 0, I = 0
Proceso 1: i = 1, I = 1
...
Proceso 1: i = 49, I = 49
Proceso 2: i = 0, I = 0
...
Proceso 20984 con id = 3 terminado
Proceso 20985 con id = 4 terminado
Proceso 20983 con id = 2 terminado
Proceso 20982 con id = 1 terminado
Proceso 20986 con id = 5 terminado
Observación: Cada proceso hijo empieza con
I = 0porque la memoria fue duplicada en la llamada afork(). Las modificaciones deIen un hijo no afectan a los demás procesos.
Pregunta: Si los procesos se ejecutan de forma concurrente, ¿no deberían salir las iteraciones intercaladas entre los distintos procesos? ¿Por qué salen impresas primero todas las iteraciones del Proceso 1 antes que las del Proceso 2?
Demostración de Aislamiento de Memoria Virtual (
forkmalloc.c): (Código disponible enforkmalloc.c)
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>

int main() {
    char *c = malloc(10);
    c[3] = 'A';
    if (fork() == 0) {
        c[3] = 'C'; // Modificación en el hijo
        printf("HIJO:  dirección=%p, valor c[3]=%c\n", c, c[3]);
    } else {
        sleep(1);
        printf("PADRE: dirección=%p, valor c[3]=%c\n", c, c[3]);
    }
}
Salida en terminal:
HIJO:  dirección=0x2b4e010, valor c[3]=C
PADRE: dirección=0x2b4e010, valor c[3]=A
Explicación: Aunque padre e hijo muestran exactamente la misma dirección de memoria virtual (
0x2b4e010), la técnica Copy-On-Write (COW) hace que al modificarc[3], el sistema operativo cree una copia física independiente de la página de memoria.
Ejemplo alternativo en memoria dinámica (
forkmalloc2.c): (Código disponible enforkmalloc2.c) Demuestra cómo una llamada astrcpy(array, "Goodbye")en el proceso hijo tras unmalloc()no altera el buffer del proceso padre ("Hello"), garantizando aislamiento total.
Hilos
Concepto y ciclo de vida
-
Los hilos permiten concurrencia dentro de cada proceso
-
Los procesos son entidades pesadas
- la estructura del proceso está en la parte del núcleo, y cada vez que un proceso quiere acceder a ella tiene que hacer una llamada al sistema y consumir tiempo de procesador
-
Los hilos son entidades ligeras: la estructura de hilos reside en el espacio de usuario.
- Los hilos comparten la información del proceso, por lo que si un hilo modifica una variable de proceso, el resto de hilos verán esa modificación cuando accedan a esa variable.
- El cambio de contexto entre hilos consume poco tiempo de procesador, de ahí su éxito.
Tipos y niveles de hilos
Hilos y hardware
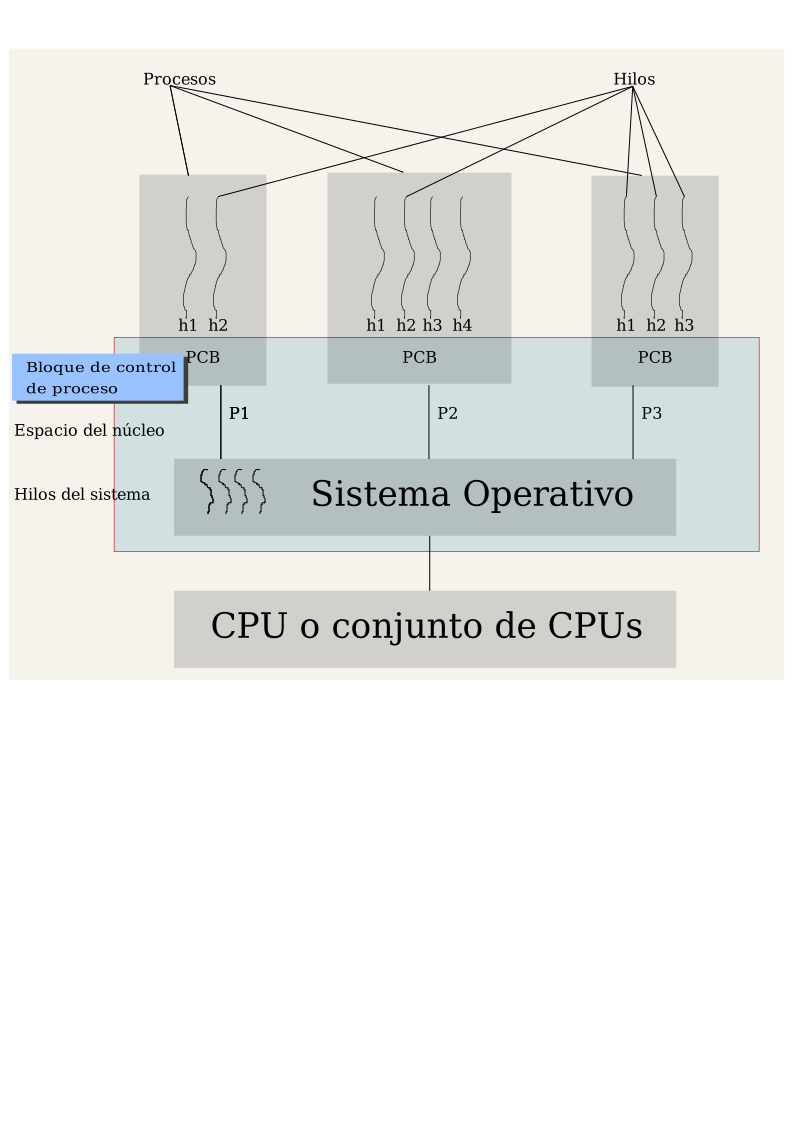
Figure 3: Hilos y hardware.
Niveles de hilos
- Hoy en día es normal que nos encontremos con dos 'niveles' de
hilos
- El que nos proporcione el lenguaje de programación empleado, p.e. Java
- El que proporciona el SO.
- Lo habitual es que el primero se reescriba mediante llamadas a este segundo -uno a uno, muchos a uno, muchos a muchos-.
Procesos ligeros
-
Hoy en día los SO ofrecen el concepto de proceso ligero (LWP: Light Weight Process).
-
Un LWP se ejecuta en espacio de usuario y esta sustentado por un thread o hilo.
-
Un LWP comparte su espacio de direcciones y recursos del sistema con otros LWP que pueda crear el mismo proceso.
-
Asociado al concepto de
hiloaparece el de almacenamiento local al hilo -Thread Local Storage- oTLS.-
Lenguajes como D lo usan por defecto.
-
En el caso de
C++debemos emplearC++11o superior para tener soporteTLS. -
En el caso de Rust disponemos de la macro
thread_local! -
Y en Java tenemos la clase ThreadLocal<T>.
-
Implementación de hilos
Hilos en Unix con C (POSIX)
- Se emplea la biblioteca
pthread(POSIX threads), la interfaz estándar más utilizada en entornos Unix/Linux.
#include <pthread.h>

int       pthread_create(pthread_t *thread, const pthread_attr_t *attr,
                         void *(*start_routine) (void *), void *arg); // Crear hilo
pthread_t pthread_self(void);  // Devuelve el ID del hilo actual
void      pthread_exit(void *retval); // Terminar el hilo actual
int       pthread_join(pthread_t thread, void **retval); // Esperar a un hilo (bloqueante)
int       pthread_detach(pthread_t thread); // Desvincular hilo (libera recursos al terminar)
Ejemplo práctico de hilos en C (POSIX
pthread): (Código disponible enhilos.c)
#include <pthread.h>
#include <stdio.h>
#include <string.h>
#include <stdlib.h>

#define NUM_HILOS 5
int I = 0; // Variable global compartida por todos los hilos

void *codigo_del_hilo (void *id) {
    int i;
    for(i = 0; i < 50; i++)
        printf("Hilo %d: i = %d, I = %d\n", *(int *)id, i, I++);
    pthread_exit (id);
}

int main() {
    int h;
    pthread_t hilos[NUM_HILOS];
    int id[NUM_HILOS] = {1,2,3,4,5};
    int error;
    int *salida;

    for(h = 0; h < NUM_HILOS; h++) {
        error = pthread_create(&hilos[h], NULL, codigo_del_hilo, &id[h]);
        if (error) {
            fprintf (stderr, "Error: %d: %s\n", error, strerror (error));
            exit(-1);
        }
    }

    for(h = 0; h < NUM_HILOS; h++) {
        error = pthread_join(hilos[h], (void **)&salida);
        if (error)
            fprintf (stderr, "Error: %d: %s\n", error, strerror (error));
        else
            printf ("Hilo %d terminado\n", *salida);
    }
}
Salida: .>
text .> $ gcc -o hilos hilos.c -lpthread && ./hilos .> Hilo 1: i = 0, I = 0 .> Hilo 4: i = 0, I = 2 .> Hilo 4: i = 1, I = 4 .> Hilo 3: i = 0, I = 1 .> Hilo 1: i = 1, I = 3 .> ... .> Hilo 1 terminado .> Hilo 2 terminado .> Hilo 3 terminado .> Hilo 4 terminado .> Hilo 5 terminado .>Observación: A diferencia de los procesos, todos los hilos comparten la misma variable globalI, por lo que sus salidas se intercalan y modifican la misma memoria.
Un error extremadamente común en C es pasar la dirección de la variable del bucle &h a pthread_create():
// CÓDIGO ERROREO
for (int i = 0; i < 5; i++) {
    pthread_create(&hilos[i], NULL, funcion, &i); // ¡ERROR! Todos reciben el puntero a la misma variable i
}
Salida precalculada del error:
$ ./hilos_error
Hilo 5 procesando...
Hilo 5 procesando...
Hilo 5 procesando...
Hilo 5 procesando...
Hilo 5 procesando...
El hilo principal incrementa i en el bucle for antes de que los hilos recién creados tengan tiempo de leer el valor apuntado por &i. Cuando los hilos finalmente leen *arg, la variable i ya vale 5.
Estado de los Hilos: Joinable vs Detached
- Hilos Joinable (por defecto): Al terminar la ejecución de la función del hilo, sus recursos internos en el SO no se liberan inmediatamente. El kernel mantiene su código de salida a la espera de que el proceso padre invoque
pthread_join(). Si no se invocapthread_join(), se produce una fuga de memoria/recursos en la tabla de hilos del kernel (similar a un proceso Zombie). - Hilos Detached: Al desvincular un hilo con
pthread_detach(thread_id)o crearlo con el atributoPTHREAD_CREATE_DETACHED, el hilo se vuelve totalmente autónomo (fire and forget). Tan pronto como termina su ejecución, el sistema operativo libera automáticamente todos sus recursos, sin necesidad de llamar apthread_join().
Atributos de Hilos (pthread_attr_t)
La estructura de atributos permite personalizar el comportamiento del hilo antes de su lanzamiento:
pthread_attr_setstacksize(&attr, size): Ajustar el tamaño de la pila del hilo (útil si la pila por defecto es demasiado grande para miles de hilos o pequeña para recursión profunda).pthread_attr_setschedpolicy(&attr, SCHED_FIFO): Establecer la política de planificación del kernel (SCHED_OTHERpor defecto,SCHED_FIFOoSCHED_RRpara tiempo real).
Herramientas de diagnóstico
Los compiladores actuales (GCC y Clang/LLVM) incluyen la herramienta ThreadSanitizer (-fsanitize=thread o TSan). Al compilar con este flag, el compilador instrumenta cada acceso a memoria e intercepta las primitivas de sincronización de pthread. Si dos hilos acceden a la misma ubicación de memoria simultáneamente y al menos uno de los accesos es de escritura sin coordinarse mediante un cerrojo, el runtime emite un informe en la terminal en tiempo de ejecución.
Ejemplo real de condición de carrera en C++ (ver
tsn.cc)
// g++ -fsanitize=thread -g -pthread tsn.cc -o tsn
#include <pthread.h>
#include <stdio.h>
#include <string>
#include <map>

typedef std::map<std::string, std::string> map_t;

void *threadfunc(void *p) {
    map_t& m = *(map_t*)p;
    m["foo"] = "bar"; // Escritura en el hilo secundario
    return 0;
}

int main() {
    map_t m;
    pthread_t t;
    pthread_create(&t, 0, threadfunc, &m);
    printf("foo=%s\n", m["foo"].c_str()); // ¡ERROR! Lectura concurrente sin join
    pthread_join(t, 0);
}
Compilación y ejecución:
g++ -fsanitize=thread -g -pthread tsn.cc -o tsn
./tsn
Salida:
==================
WARNING: ThreadSanitizer: data race (pid=28491)
  Write of size 8 at 0x7fff5fbff080 by thread T1:
    #0 std::map<std::string, std::string>::operator[] /usr/include/c++/v1/map:1540
    #1 threadfunc(void*) /home/usuario/tsn.cc:14 (tsn+0x100000ed0)

  Previous read of size 8 at 0x7fff5fbff080 by main thread:
    #0 std::map<std::string, std::string>::operator[] /usr/include/c++/v1/map:1540
    #1 main /home/usuario/tsn.cc:22 (tsn+0x100000f40)

  Location is stack of main thread at 0x7fff5fbff080.
==================
ThreadSanitizer: reported 1 warnings
ThreadSanitizer detecta un acceso concurrente no protegido (o condición de carrera) entre la escritura en tsn.cc:14 por T1 y la lectura simultánea en tsn.cc:22 por el hilo principal sobre el objeto m.
Solución sincrónica: (ver
tsn2.cc)
// g++ -g -pthread tsn2.cc -o tsn2
#include <pthread.h>
#include <stdio.h>
#include <string>
#include <map>

typedef std::map<std::string, std::string> map_t;

void *threadfunc(void *p) {
    map_t& m = *(map_t*)p;
    m["foo"] = "bar";
    return 0;
}

int main() {
    map_t m;
    pthread_t t;
    pthread_create(&t, 0, threadfunc, &m);
    pthread_join(t, 0); // Sincronización explícita antes de leer
    printf("foo=%s\n", m["foo"].c_str());
}
Alternativa de análisis dinámico con Valgrind/Helgrind (ver
race.c)
/*
 * Sincronización y detección con Helgrind:
 * valgrind --tool=helgrind ./race
 */
#include <pthread.h>
#include <stdlib.h>
#include <unistd.h>

int Global;

void* Thread1(void *x) {
    Global = 42;
    return x;
}

int main(void) {
    pthread_t t;
    pthread_create(&t, NULL, Thread1, NULL);
    for(int i = 0; i < 10000000 ; i++) ; // Espera activa simulada sin cerrojo
    Global = 43;
    pthread_join(t, NULL);
    return Global == 42 ? EXIT_SUCCESS : EXIT_FAILURE;
}
Helgrind permite identificar condiciones de carrera en binarios Unix sin necesidad de recompilar con flags de sanitizer.
Hilos en Python
- Python permite crear hilos usando el módulo nativo
threading. - Un hilo es una unidad de ejecución dentro del mismo proceso Python.
- Los hilos se inician con
start()y se espera su finalización conjoin().
El GIL (Global Interpreter Lock) y la Gestión de Memoria en CPython
- ¿Por qué existe el GIL? La implementación estándar de Python (CPython) utiliza Conteo de Referencias (
sys.getrefcount()) para la recolección de basura (Garbage Collection). Sin el GIL, el incremento y decremento concurrente de contadores de referencia sobre objetos compartidos provocaría corrupción de memoria. - El GIL es un cerrojo global que obliga a que solo un hilo ejecute bytecode de Python a la vez, independientemente del número de núcleos de CPU disponibles.
- Mapeo de casos de uso:
- Cargas de E/S (I/O-Bound): Los hilos liberan el GIL mientras esperan respuestas del disco o red (
time.sleep, llamadas a socket, base de datos). Usarthreadinges altamente eficiente. - Cargas de Cálculo (CPU-Bound): Varios hilos compiten por el GIL creando un cuello de botella.
threadingNO acelera tareas CPU-Bound. Para CPU-Bound se debe usar el módulomultiprocessing.
- Cargas de E/S (I/O-Bound): Los hilos liberan el GIL mientras esperan respuestas del disco o red (
- Evolución (PEP 703): Python 3.13+ introduce soporte experimental para compilar CPython sin GIL (Free-threaded Python), eliminando esta barrera históricamente.
Ejemplo práctico: Benchmark de GIL (I/O-Bound vs CPU-Bound):
import threading
import time

def tarea_cpu():
    count = 0
    for _ in range(10_000_000):
        count += 1

def tarea_io():
    time.sleep(1.0) # Simula espera de red o disco

# Medición CPU-Bound con 4 hilos frente a 1 hilo
t0 = time.perf_counter()
hilos = [threading.Thread(target=tarea_cpu) for _ in range(4)]
for h in hilos: h.start()
for h in hilos: h.join()
print(f"Tiempo CPU-Bound (4 hilos): {time.perf_counter() - t0:.2f} segundos")

# Medición I/O-Bound con 4 hilos frente a 1 hilo
t0 = time.perf_counter()
hilos = [threading.Thread(target=tarea_io) for _ in range(4)]
for h in hilos: h.start()
for h in hilos: h.join()
print(f"Tiempo I/O-Bound (4 hilos): {time.perf_counter() - t0:.2f} segundos")
Salida:
$ python3 benchmark_gil.py
Tiempo CPU-Bound (4 hilos): 2.41 segundos  (Secuencial tardaba 2.10s -> ¡El GIL lo ralentiza!)
Tiempo I/O-Bound (4 hilos): 1.01 segundos   (Secuencial tardaba 4.00s -> ¡Aceleración de 4x!)
Ejemplo de hilos en Python (
threading): (verhilos.py)
import threading

THREADS = 2
MAX_COUNT = 10000000
counter = 0

def thread():
    global counter
    print(f"Thread {threading.current_thread().name}")
    for i in range(MAX_COUNT // THREADS):
        counter += 1

def main():
    threads = []
    print("Starting...")
    for i in range(THREADS):
        t = threading.Thread(target=thread)
        threads.append(t)
        t.start()

    for t in threads:
        t.join()

    if counter != MAX_COUNT:
        print(f"Counter value: {counter} Expected: {MAX_COUNT}\n")

if __name__ == "__main__":
    main()
Hilos en Windows
-
En Windows, los hilos se crean utilizando la función
CreateThreadde la API del sistema. -
Un hilo es una unidad de ejecución que corre en paralelo dentro del mismo proceso.
-
Se define una función que ejecutará el hilo.
-
Con
CreateThread, se lanza el hilo, pasando como parámetro la función a ejecutar. -
Para sincronizar, se puede usar
WaitForSingleObjectpara esperar a que el hilo termine. -
Esta API permite mayor control sobre la ejecución y gestión de hilos en aplicaciones Windows nativas.
-
La función principal de creación de hilos en el
APIde Windows es CreateThread.
#include <windows.h>
#include <iostream>
using namespace std;
DWORD Cont=0; // Variable compartida
DWORD WINAPI incrementar(LPVOID param)
{
DWORD n = *(DWORD*)param;
//int i;
for(int i = 0; i < n; i++)
{
Cont++;
cout << "Contador sumando = " << Cont << "\n";
}
return 0;
}
DWORD WINAPI decrementar(LPVOID param)
{
DWORD n = *(DWORD*)param;
for (int i = 0; i < n; i++)
{
Cont--;
cout << "Contador restando = " << Cont << "\n";
}
return 0;
}
int main(int argc, char *argv[]) {
DWORD TIdi,TIdd;
HANDLE THandlei,THandled;
int param = 100;
//Creamos dos threads
THandlei = CreateThread(NULL,0,incrementar,¶m,0,&TIdi);
THandled = CreateThread(NULL,0,decrementar,¶m,0,&TIdd);
cout << "Contador = " << Cont << "\n";
//Esperamos a que acaben todos los threads
WaitForSingleObject(THandlei,INFINITE);
WaitForSingleObject(THandled,INFINITE);
//Eliminamos los threads
CloseHandle(THandlei);
CloseHandle(THandled);
cout << "Contador = " << Cont << "\n";
system("PAUSE");
}
Hilos en Java
Hilos en Java: ciclo de vida
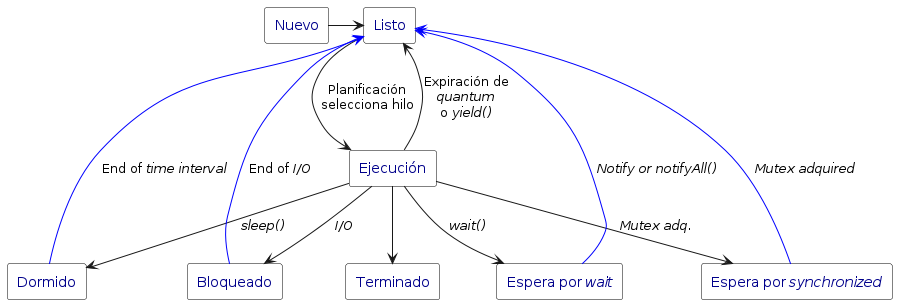
Figure 4: Ciclo de vida en Java.
Hilos y objetos
- Los hilos se representan en Java mediante la clase Thread.
- Sus métodos junto con algunos de la clase Object nos permiten un manejo completo de los hilos.
- Para cada programa Java existe un hilo de ejecución denominado hilo principal.
- Diferencia entre objeto e hilo:
- Un objeto es algo estático, con una serie de atributos y métodos.
- Pero quien ejecuta esos métodos es el hilo de ejecución.
Creación de hilos
- Clase
Threadde Java - Dos posibilidades:
- Heredar de la clase
Threadpublic class FilosofoThread extends Thread {...public void run() { ... }...} - Implementar la interfaz
Runnablee instanciar unThreadcon un objeto que implemente esta interfaz.public class FilosofoRunnable implements Runnable {...public void run() { ... }...}
- Heredar de la clase
- En ambos casos hay que definir el método
run(). Este método:- Contiene el código del hilo.
- Se invoca cuando se ejecuta el hilo.
- Cuando acaba de ejecutarse el método, el hilo termina.
- Para ejecutar un hilo hay que instanciar un objeto
Thready llamar al métodostart()://creaciónThread filosofo = new FilosofoThread(); //herenciaThread filosofo = new Thread(new FilosofoRunnable()); //interface//ejecución para ambos casosfilosofo.start();
Heredando de Thread
-
Heredando de Thread y redefiniendo el método
runclass ThreadConHerencia extends Thread {String palabra;public ThreadConHerencia (String p) {palabra=p;}public void run() {for (int i = 0; i < 10; i++) {System.out.println(palabra);}}public static void main(String[]args){Thread a = new ThreadConHerencia("hilo1");Thread b = new ThreadConHerencia("hilo2");a.start();b.start();System.out.println("Fin del hilo principal");}} -
Se intercalan las salidas de los tres hilos, recordemos que tenemos el hilo principal y los dos creados
Implementando la interfaz Runnable
-
Implementamos la interfaz
Runnable, esta interfaz sólo tiene un método con la signaturapublic void run(). -
Este método es el que como mínimo tenemos que implementar en la clase.
public class ThreadConRunnable implements Runnable {String palabra;public ThreadConRunnable (String p){palabra=p;}public void run() {for(int i = 0; i < 10; i++)System.out.print(palabra);}} -
Hasta aquí simplemente hemos creado una clase. Al contrario que antes, los objetos de esta clase no serán hilos ya que no hemos heredado de Thread.
-
Si queremos que el objeto de esta clase se ejecute como un hilo independiente debemos crear un objeto de la clase Thread y pasarle como parámetro el objeto donde queremos que empiece su ejecución ese hilo.
public static void main(String[]args){ThreadConRunnable a = new ThreadConRunnable("hilo1");ThreadConRunnable b = new ThreadConRunnable("hilo2");Thread t1 = new Thread(a);Thread t2 = new Thread(b);t1.start();t2.start();System.out.println("Fin del hilo principal");}
Diferencia entre start() y run()
- Llamar a
.start()solicita al sistema operativo la creación de un nuevo hilo nativo y la JVM ejecuta el método.run()en ese hilo independiente. - Llamar a
.run()solo ejecuta el método sin crear ningún hilo nuevo.
Ejemplo:
public class DemoStartRun {
    public static void main(String[] args) {
        Thread hilo = new Thread(() -> {
            System.out.println("Ejecutando en: " + Thread.currentThread().getName());
        });

        System.out.print("Invocando run():  ");
        hilo.run(); // Se ejecuta en el hilo actual (main)

        System.out.print("Invocando start(): ");
        hilo.start(); // Se ejecuta en un hilo nuevo (Thread-0)
    }
}
Salida:
$ javac DemostraciónStartRun.java && java DemostraciónStartRun
Invocando run():  Ejecutando en: main
Invocando start(): Ejecutando en: Thread-0
Hilos de Demonio (Daemon Threads)
- En Java, los hilos pueden configurarse como Hilos Daemon mediante
hilo.setDaemon(true)antes de lanzarlos con.start(). - Regla de apagado de la JVM: La Máquina Virtual de Java finaliza su proceso automáticamente cuando todos los hilos normales (no-daemon) han terminado, sin esperar a que concluyan los hilos Daemon. Son ideales para tareas de mantenimiento en segundo plano (como el Garbage Collector o registradores de métricas).
Hilos Virtuales en Java (Java 21+ / Proyecto Loom)
Desde Java 21 (LTS), la plataforma introduce oficialmente los Hilos Virtuales (Virtual Threads), ofreciendo dos alternativas de concurrencia:
- Hilos de Plataforma (Platform Threads — Modelo 1:1): Los hilos tradicionales mapeados 1 a 1 directamente a hilos nativos del sistema operativo. Tienen un consumo de memoria relevante ( de pila por hilo) y un límite práctico en unos pocos miles por proceso.
- Hilos Virtuales (Virtual Threads — Modelo M:N): Hilos ultraligeros gestionados en espacio de usuario por la propia JVM. La JVM distribuye dinámicamente miles de hilos virtuales sobre un grupo pequeño de hilos de soporte nativos (Carrier Threads) ejecutándose en paralelo sobre los núcleos físicos del procesador.
- Caso de uso principal: Permiten escalar aplicaciones intensivas en E/S (I/O-Bound) (servidores HTTP/REST, microservicios, consultas a base de datos) a cientos de miles o millones de tareas concurrentes con un impacto mínimo en memoria y sin sobrecoste de cambios de contexto en el kernel.
Sintaxis de uso en Java 21+:
Thread hiloVirt = Thread.ofVirtual().start(() -> {
    System.out.println("Ejecutando en hilo virtual: " + Thread.currentThread());
});
Prioridades de Hilos en Java
(ver ComprobarPrioridad.java)
- Mapeo al SO: La JVM mapea los niveles de prioridad de Java (
Thread.MIN_PRIORITY = 1aThread.MAX_PRIORITY = 10) a las prioridades nativas del sistema operativo. - Advertencia de portabilidad: Las prioridades son solo sugerencias al planificador. En planificadores modernos como Linux CFS (Completely Fair Scheduler), la prioridad no impide la expropiación por rodaja de tiempo, por lo que nunca deben utilizarse para garantizar el orden de ejecución entre hilos.
public class ComprobarPrioridad implements Runnable {
    int num;
    ComprobarPrioridad(int c) { num = c; }
    public void run() {
        while (true) { System.out.println(num); }
    }

    public static void main(String[] args) {
        Thread nueva;
        for (int c = 0; c < 10; c++) {
            nueva = new Thread(new ComprobarPrioridad(c));
            if (c == 0) nueva.setPriority(Thread.MAX_PRIORITY);
            nueva.start();
        }
    }
}
Hilos en Rust
Creación de hilos (std::thread::spawn)
- Todo lo relacionado con hilos se encuentra en el módulo nativo
std::thread. - Creamos un hilo mediante la llamada a la función
std::thread::spawn.
use std::thread;
use std::time::Duration;

fn main() {
    let handle = thread::spawn(|| {
        for i in 1..5 {
            println!("Hola número {} desde el hilo hijo!", i);
            thread::sleep(Duration::from_millis(1));
        }
    });

    for i in 1..3 {
        println!("Hola número {} desde el hilo principal!", i);
        thread::sleep(Duration::from_millis(1));
    }

    handle.join().unwrap(); // Espera a que el hilo hijo termine
}
El Sistema de Traits de Concurrencia de Rust: Send y Sync
La seguridad en concurrencia de Rust (Fearless Concurrency) no depende de un runtime pesado ni de un GIL, sino de su sistema de tipos en tiempo de compilación basado en dos marker traits:
Send: Indica que la propiedad de un tipo se puede transferir de un hilo a otro de forma segura.Sync: Indica que es seguro que múltiples hilos accedan a referencias inmutiles (&T) del mismo tipo simultáneamente.
Ejemplo práctico: Detección de tipos no seguros en tiempo de compilación (Rc vs Arc)
Si un desarrollador intenta compartir un contador de referencias no seguro para hilos (Rc<T>) dentro de un thread::spawn, el compilador de Rust rechaza el programa antes de generar el binario.
Código con error de compilación:
use std::rc::Rc;
use std::thread;

fn main() {
    let datos = Rc::new(42);
    // ¡ERROR! Rc<T> no implementa el trait Send y no puede enviarse a otro hilo
    thread::spawn(move || {
        println!("Datos: {}", datos);
    });
}
Salida precalculada del compilador de Rust (
rustc):
error[E0277]: `Rc<i32>` cannot be sent between threads safely
  --> main.rs:7:19
   |
7  |       thread::spawn(move || {
   |  _____------------_-^
   | |     |
   | |     required by a bound introduced by this call
8  | |         println!("Datos: {}", datos);
9  | |     });
   | |_____^ `Rc<i32>` cannot be sent between threads safely
   |
   = help: the trait `Send` is not implemented for `Rc<i32>`
   = note: use `Arc` (Atomic Reference Counted) instead of `Rc`
Solución Idiomática: Referencias Atómicas (Arc) y Cerrojos (Mutex)
Para solucionar el error reportado por el compilador, sustituimos Rc<T> por Arc<T> (Atomic Reference Counter), el cual sí implementa Send y Sync de forma segura:
use std::sync::{Arc, Mutex};
use std::thread;

fn main() {
    let counter = Arc::new(Mutex::new(0));
    let mut handles = vec![];

    for _ in 0..10 {
        let counter_clone = Arc::clone(&counter);
        let handle = thread::spawn(move || {
            let mut num = counter_clone.lock().unwrap();
            *num += 1;
        });
        handles.push(handle);
    }

    for handle in handles {
        handle.join().unwrap();
    }

    println!("Resultado final acumulado: {}", *counter.lock().unwrap());
}
Salida:
$ cargo run
Resultado final acumulado: 10
Mutabilidad Interior en Rust (mi.rs)
(ver mi.rs)
- En Rust, las reglas de préstamo (borrowing) prohíben mutar un valor si existen referencias inmutables (
&T) activas. - El patrón de mutabilidad interior (interior mutability) permite mutar datos a través de una referencia inmutable (
&T), trasladando la comprobación de las reglas del tiempo de compilación al tiempo de ejecución. - Para entornos de un solo hilo se utiliza
std::cell::RefCell<T>:
use std::cell::RefCell;

struct Counter {
    // El campo interno se envuelve en RefCell
    counter: RefCell<usize>,
}

impl Counter {
    fn new() -> Counter {
        Counter {
            counter: RefCell::new(0),
        }
    }

    // Recibe &self (inmutable)
    fn increment(&self) {
        // .borrow_mut() nos da acceso de escritura temporal
        *self.counter.borrow_mut() += 1;
    }

    fn get_count(&self) -> usize {
        // .borrow() nos da acceso de lectura temporal
        *self.counter.borrow()
    }
}

fn main() {
    let counter = Counter::new(); // Es inmutable

    // Podemos obtener una referencia inmutable a la cuenta
    let count = counter.get_count();
    println!("La cuenta inicial es: {}", count);

    // Podemos incrementar la cuenta sin declarar `mut counter`
    counter.increment();

    // Podemos obtener una nueva referencia inmutable a la cuenta
    let count = counter.get_count();
    println!("La cuenta actualizada es: {}", count);
}
- Regla multihilo:
RefCell<T>NO es seguro para hilos (no implementaSync). Para mutabilidad interior en concurrencia multihilo debe sustituirse porMutex<T>oRwLock<T>. - Si se viola la regla del
RefCell<T>el programa fallará (panic). Si se viola en multihilo conMutex<T>, el hilo se bloqueará a la espera que se libere el recurso.
Aclaraciones
- En ningún caso estas transparencias son la bibliografía de la asignatura, por lo tanto debes estudiar, aclarar y ampliar los conceptos que en ellas encuentres empleando los enlaces web y bibliografía recomendada que puedes consultar en la página web de la ficha de la asignatura y en la web propia de la asignatura.